把决策模型从 API 里抢回来:33 毫秒、1G 内存,闭源 API 还剩几条活路?
把决策模型从 API 里抢回来:33 毫秒、1G 内存,闭源 API 还剩几条活路?
先说一个很多人没注意的事实:你手机里那些“很聪明”的 AI 功能,九成时间根本不是在写文章、聊天、作诗,而是在做选择题。
这封投诉邮件该转给财务还是技术?这条评论是正常吐槽还是在骂人?这句话是不是想骗你点开钓鱼链接?这条工单急不急,要不要马上叫人?
过去两年,这些活儿的标准答案只有一个:调 API,把文本发到云端,等大模型“想”几百毫秒,再把结果传回来。方便是真方便,账单也是真肉疼。
而最近在开发者圈子里被刷屏的开源项目 Laya,干的就是一件很“叛逆”的事——把这台天天替你答题的机器,从别人的机房里搬回你自己家。
它的多语言版本只有 3.2 亿参数、权重文件 600 多 MB,官方实测单次判断 33 毫秒,比人眨一次眼还快,而且是 Apache 2.0 协议,商用免费。
一句话总结这场风波:不是又一个聊天机器人,而是一次“决策权”的搬家。
一、它到底是个啥?不是会聊天的 AI,是 AI 的“条件反射”
大部分人理解的 AI,是那种你问一句它答一段的“全能顾问”。它很博学,但每次开口都按字收费,还得排队、联网、把资料交出去。
Laya 完全不是这个路数。
你可以把它想象成公司前台那位特别老练的分诊护士:来人一开口,她三秒钟就能判断“去财务”“去技术”“这人火气大,先叫主管”。她不做诊断、不开药方,但她决定了谁来做诊断。
技术上它有一堆名词,你不用记。你只需要知道三件事:
第一,它不写字,只“涂答题卡”。 你给它一段文本,再给它几道“选择题、判断题、打分题”,它直接返回选项和概率。比如“这封邮件属于哪个部门”,它答“财务,把握 86%”。
第二,正因为它不写字,所以它不会胡说八道。 现在大模型的“幻觉”,本质是“自由发挥”惹的祸——让它写一段话,它就可能编。Laya 压根没有“写”的环节,答案只能从你给的选项里挑,想编都没地方编。
第三,它是个“快思考”模型。 人的大脑有两套系统:一套是看到红灯就踩刹车,快、不用想;一套是算一道数学题,慢、要推理。Laya 专攻前者。业内管这叫 System 1,翻成大白话就是**“AI 的条件反射”**。
所以你千万别拿它跟 ChatGPT 比谁更会聊天。它俩不是一个工种。一个是坐诊专家,一个是分诊台护士——医院里缺了谁都不行,但护士一天能分诊几千人。
二、它凭什么敢喊“抢回来”?三笔账算给你看
第一笔:速度账——33 毫秒,比眨眼快三倍
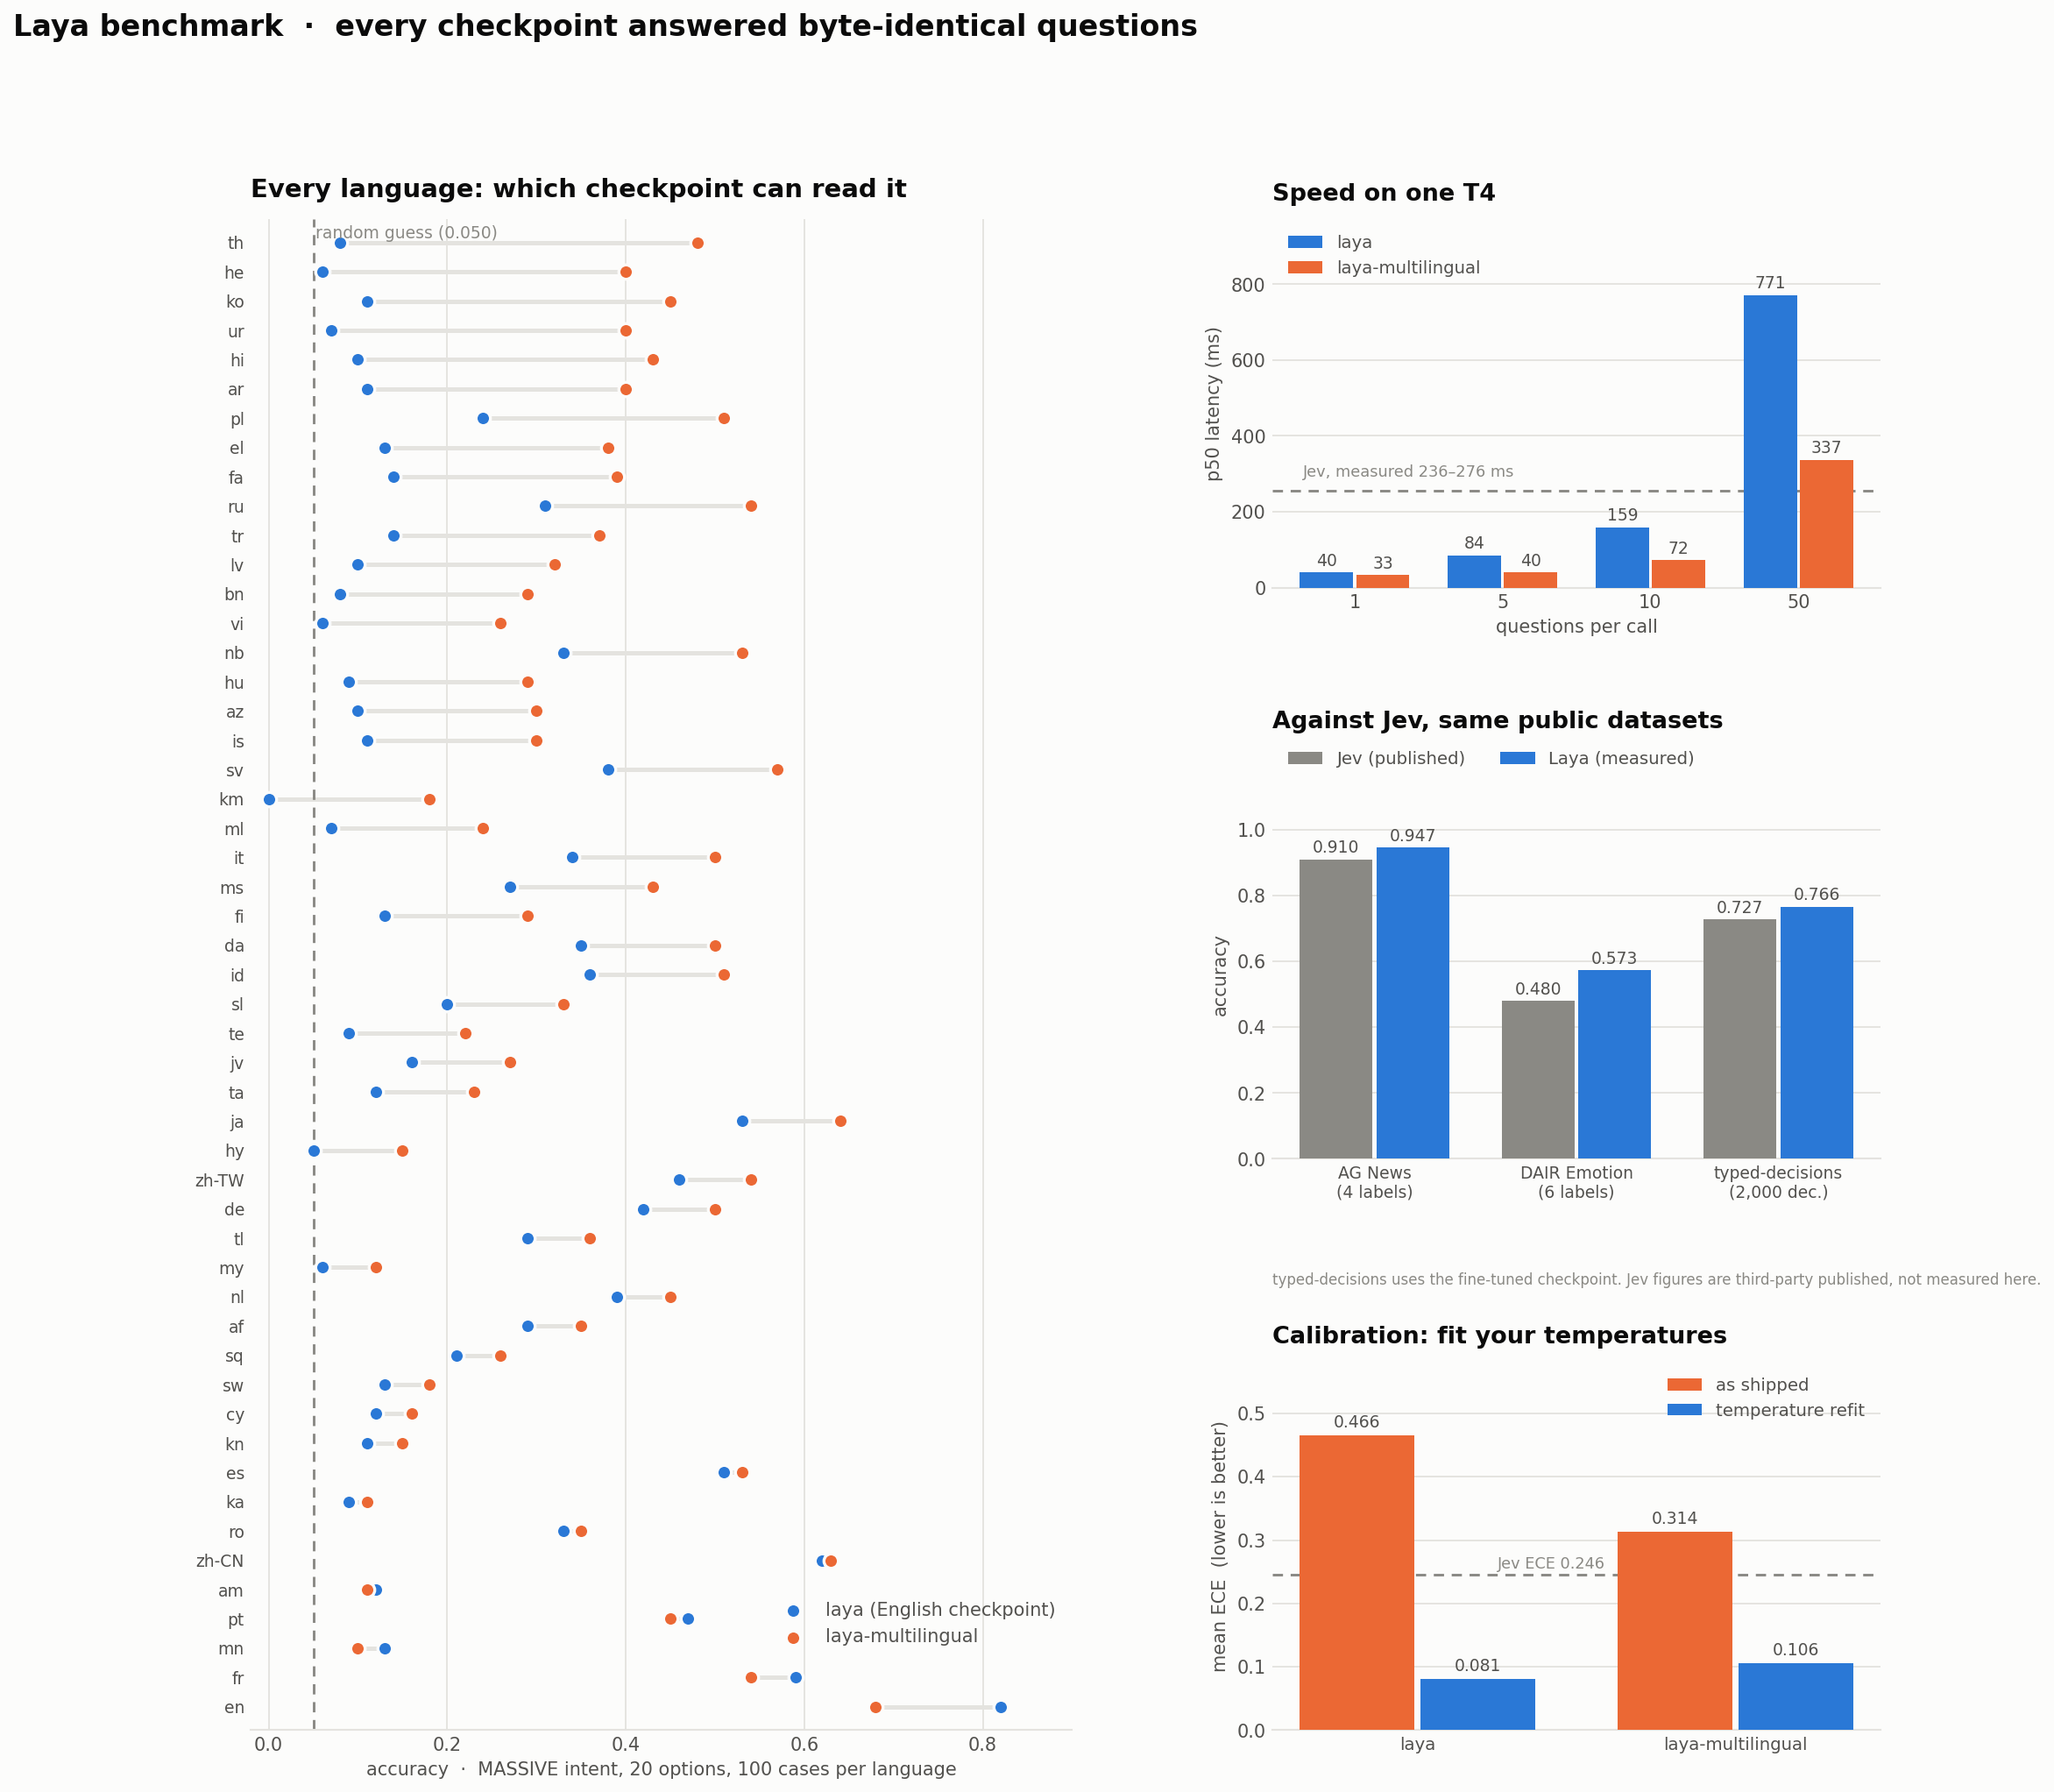
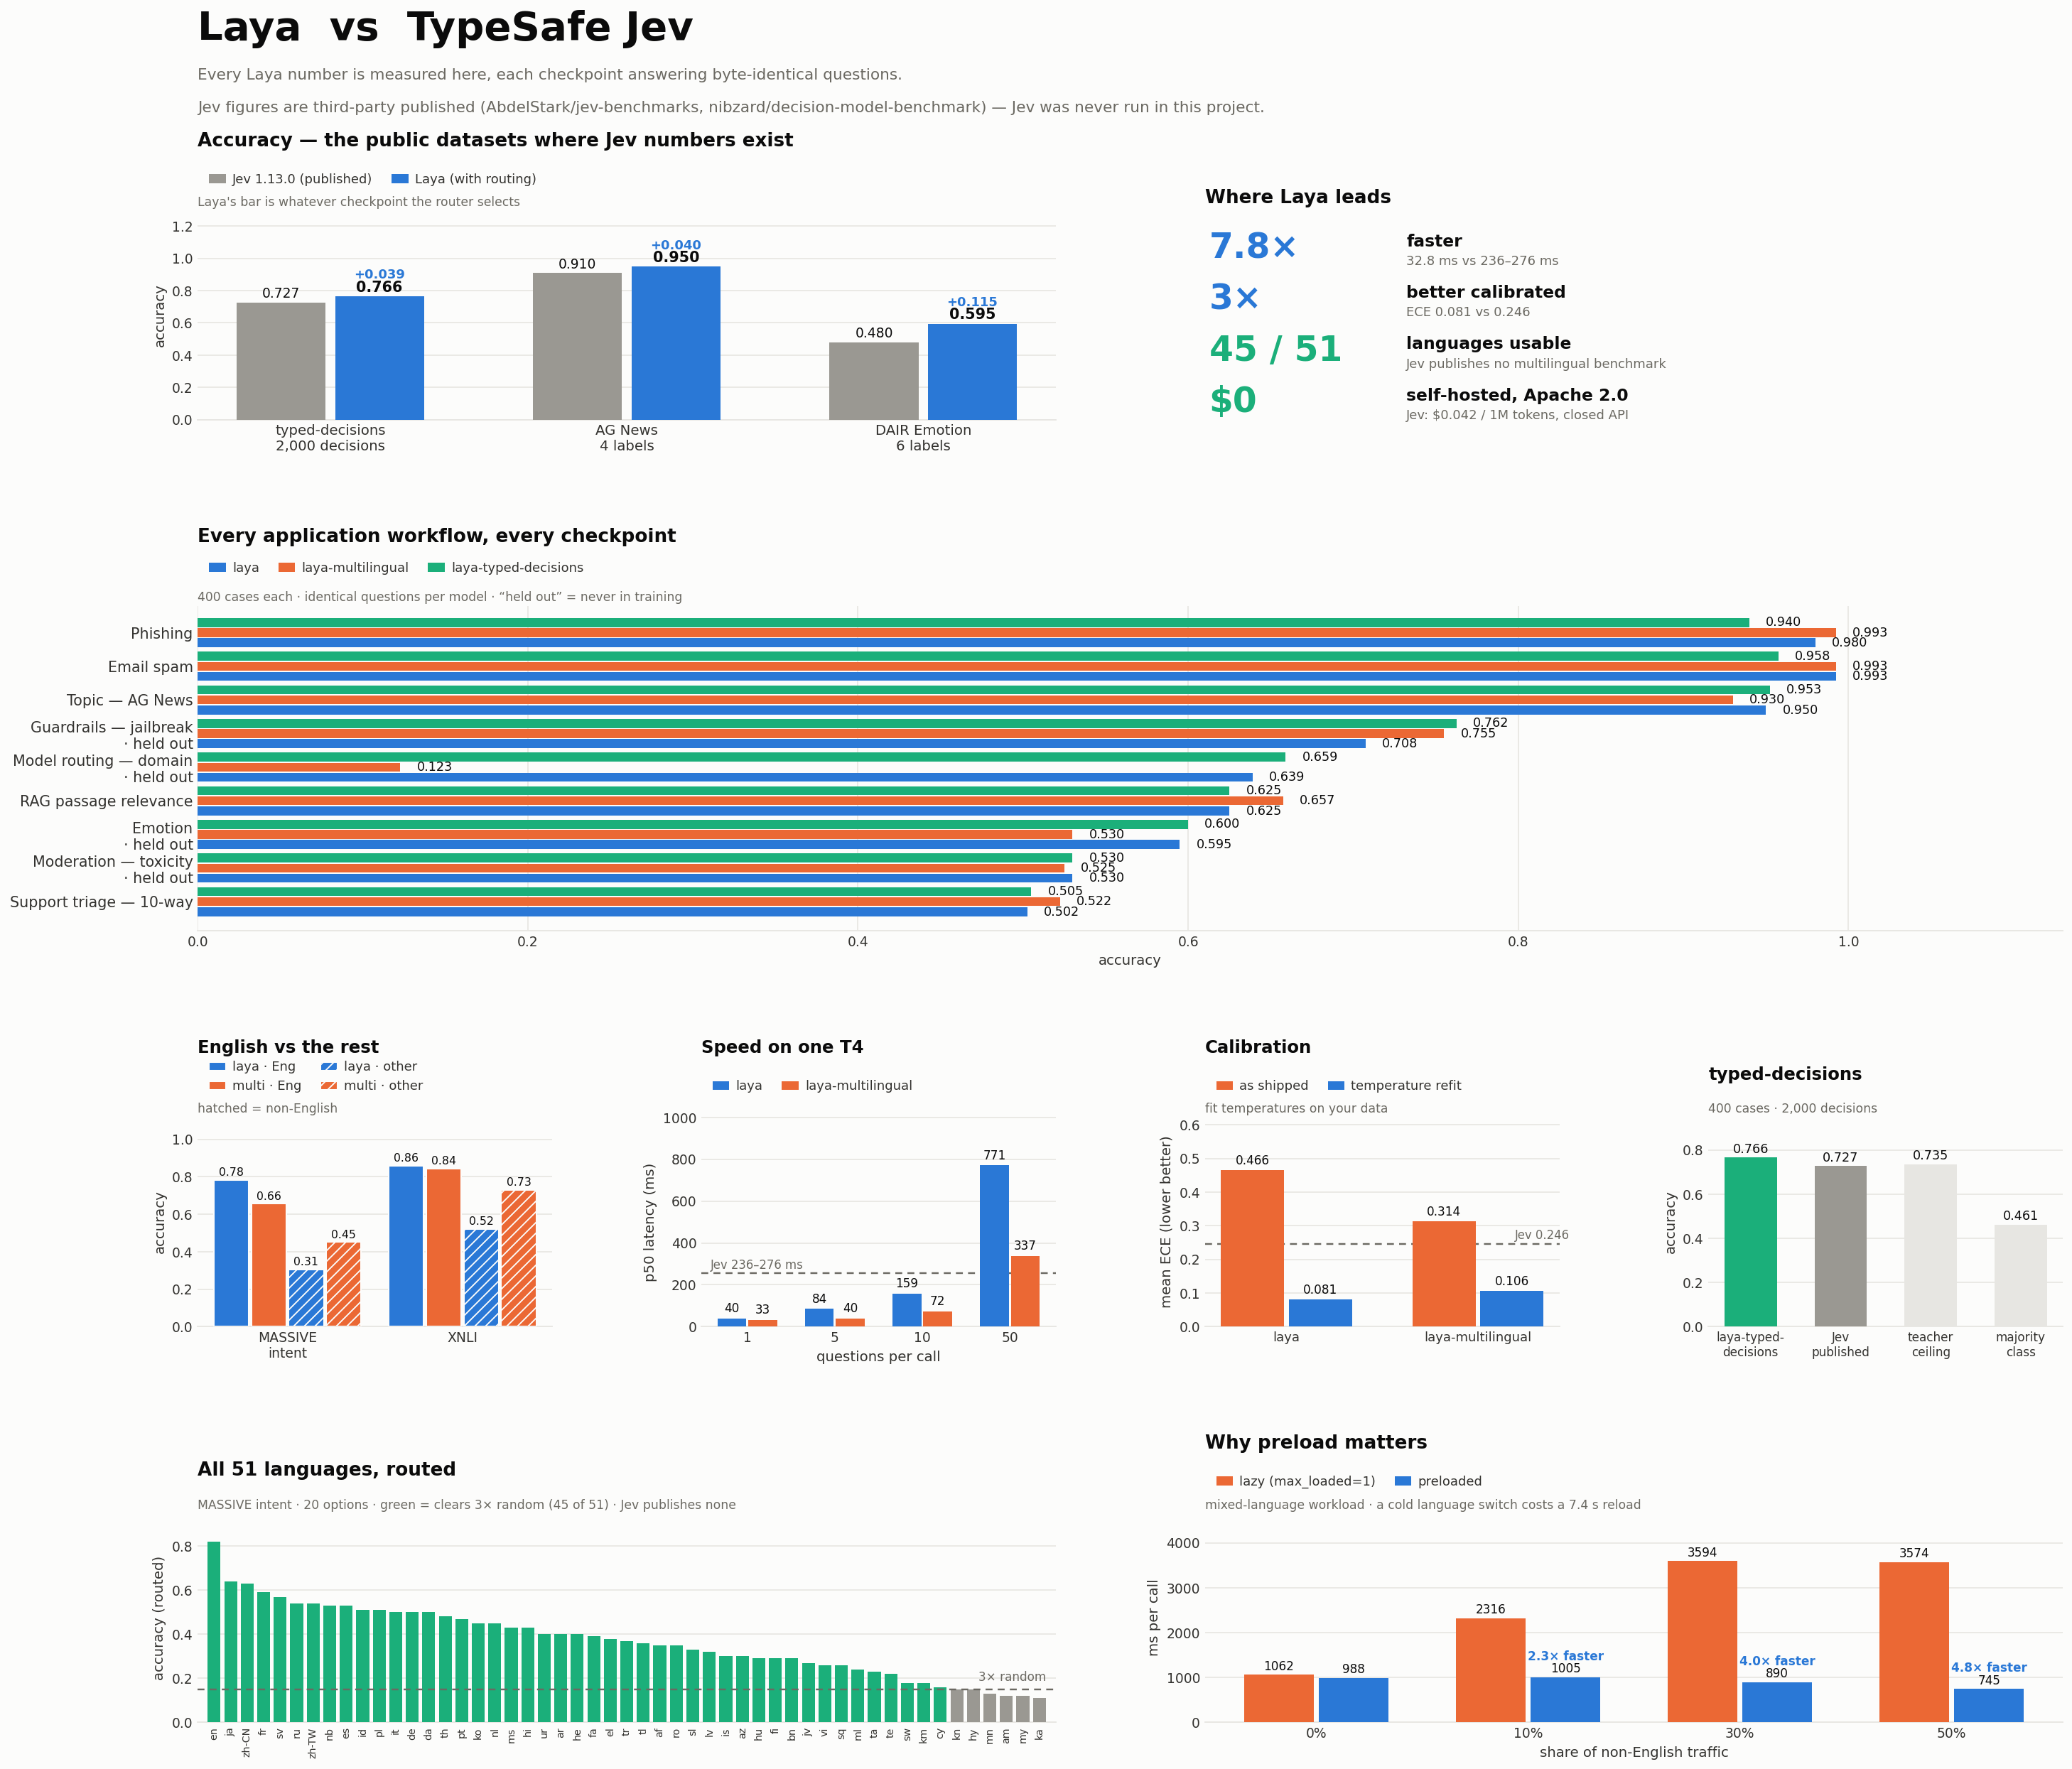
在同样的 T4 显卡上,Laya 回答 1 个问题要 32.8 毫秒;闭源的 Jev 被第三方测出来是 236 到 276 毫秒。
也就是说,快 7 倍左右。
更狠的是批量。你一次问 10 个问题,它 72 毫秒全答完,平均一个问题 7.2 毫秒;一次问 50 个,337 毫秒收工。单卡每秒能处理一百到三百多个判断。
这意味着什么?
假设一家中型平台每天要处理 100 万条工单或评论。按这个速度,一张显卡一个多小时就能全部判完。而在以前,这些请求要排队、要限流、要盯着调用配额,高峰期还得祈祷对方别抽风。
客服系统里最怕的不是“答错”,是“等”。用户发完消息盯着屏幕,转圈转三秒,火气就上来了。33 毫秒,用户的感觉是“刚发出去就有人接了”。
第二笔:语言账——一个“自信地答错”的故事
这是整个项目里最精彩、也最值得所有做海外业务的人警惕的一段。
Laya 有两个版本:一个专攻英文,一个专攻多语言。测试里出现了一个堪称恐怖的现象:
那个英文模型遇到高棉语时,准确率是 0.000,但它给出的信心是 95.2%。
翻译成人话:一个只会英语的考官,拿到一张高棉语试卷,一个字看不懂,随手打了个勾,还特别自信地跟领导说“我很有把握”。
希伯来语准确率 6%,亚美尼亚语 5%(跟闭眼瞎猜一样),孟加拉语 8%——全都报着九成左右的信心。
这就是闭源 API 最隐蔽的坑:它不会告诉你“这题我不会”。你看到的是一个漂亮的置信度,实际拿到的是一堆错误标签,然后这些错误标签会顺着流程一路往下走,最后变成发错的货、得罪的客户、封错的账号。
Laya 的解法很土,但很有效:先看字长什么样,再决定派谁上场。
它的路由模块不看内容,只看“字形”——是天城文、阿拉伯文、汉字还是拉丁字母,0.5 毫秒内就能判断,然后把单子分给对应的模型。像医院门口那块“发热门诊往左,骨科往右”的指示牌,简单、粗暴、管用。
效果有多明显?在 51 种语言的大考里:
- 韩语从 0.110 拉到 0.490
- 阿拉伯语从 0.110 拉到 0.400
- 印地语从 0.100 拉到 0.387
- 跨语言推理测试里,非英语的 14 种语言从 0.521 涨到 0.731
51 种语言里,有 45 种以上达到了“能用”的水平。
对做出海生意的中国团队来说,这一条的价值可能比省钱大得多。东南亚的印尼语、泰语、越南语,中东的阿拉伯语,南美的葡语西语——以前要么硬塞给英文模型(然后自信地答错),要么每种语言单独训一个模型(成本爆炸)。现在一个几百兆的小模型加一个路由器,就能兜住大半个地球。
第三笔:钱包和隐私账——1G 内存,数据不出门
先说钱,但别急着欢呼。
闭源 Jev 的公开报价是 每百万 token 0.042 美元,折合人民币三毛钱左右。单看单价,其实不贵,甚至可以说便宜。
但账要这么算:一条客服工单,加上问题描述和选项,轻松就是五六百 token。一天 100 万条,就是 6 亿 token,一天 25 美元,一年六万多人民币。这还只是一条业务线,还没算你为了“多问几个问题”而翻倍的消耗。
自己部署呢?一张二手 T4 或者一张消费级显卡,一次性投入一两万,能同时跑好几个业务,还能闲时干别的活。电费另算,但不是大头。
媒体那边流传更夸张的说法:1GB 内存就能跑起来。考虑到权重文件本身才 600 多 MB,这个说法并不离谱。也就是说,一台普通办公电脑、一台小服务器,甚至一台 Mac,都能当它的“工位”。
更关键的是隐私。
客服工单里有什么?身份证号、订单号、手机号、家庭住址、病历描述、合同金额。这些东西一旦上云,就要面对跨境传输、数据留存、第三方审计一连串合规问题。很多行业——银行、医院、政务、律所——不是不想用 AI,是根本不敢把原文发出去。
本地跑,数据不出内网。这一条,比省下的那点 token 钱值钱得多。
还有个特别“杀人诛心”的细节:Laya 自带一个 和闭源 Jev 完全兼容的 HTTP 接口。
什么意思?你原来写的代码、你正在用的客户端,几乎一行不用改,只要把请求地址从对方的域名改成你自己机器的地址,业务就跑到本地了。
这大概就是“把决策模型从 API 里抢回来”这句话,最生动的注脚。
三、普通人能玩吗?门槛比你想的低
能,而且门槛低得有点不真实。
它是标准的 Python 包,一行安装命令搞定;官方给了在线体验页面,打开网页就能试;本地还有个网页版小工作台,左边贴文本,右边勾问题,按一下回车看结果,连代码都不用写。
硬件上,它不挑食:有显卡用显卡,没显卡用 CPU。Mac 上有专门的 MLX 原生版本,端到端延迟做到 7 到 13 毫秒;浏览器和 Node.js 有 TypeScript 版本;社区还把它搬到了华为昇腾的 NPU 上,速度快了几十倍。
适合谁?
- 中小企业的技术负责人:客服分流、工单打标、邮件分类,一套本地服务全包,不用按量付费。
- 内容平台和社区运营:评论审核、垃圾广告识别、违规话术拦截,毫秒级响应,还不用担心用户隐私外流。
- 做出海业务的团队:一百多种语言一个模型兜住,不用为每个市场单独开项目。
- 自媒体和技术爱好者:拿它给文章自动打标签、给素材分类、给自己搭个“自动整理 inbox”的小工具,都行。
- AI Agent 开发者:这是它最被低估的用法——让大模型负责“思考和规划”,让 Laya 负责“判断和选择”。就像公司里,老板定战略,前台做分诊。
最让人意外的,是它的“补课”能力。
零基础直接用,它在复杂业务上其实很一般,甚至接近瞎猜。但你只要拿自己行业的数据喂它几个小时,效果会突变:
- 银行客服意图识别,从 45.4% 干到 93.44%;
- 浏览器自动化 Agent 找网页按钮,正确答案从 10% 提到 66%,整条任务的成功率从 0 干到 62%,每一步只花 17 到 23 毫秒。
而且补课不要钱——两张 Kaggle 免费显卡,跑四五个小时就够。
四、泼盆冷水:它有三个“死穴”
吹到这儿,必须说点不好听的。这项目最让人服气的地方,恰恰是它自己在文档里把短板列得清清楚楚。
第一,它只会做选择题,不会写作文。 你让它总结一份会议纪要、润色一段文案、解释一个概念——它干不了,也不该干。把它当 ChatGPT 用,你会非常失望。
第二,选项不能太多。 超过 20 个选项,准确率就明显往下掉;到七十多个选项时,闭源的 Jev 反而更强(银行意图数据集上 0.870 对 0.425)。原因很朴素:答题卡的格子就那么大,选项一多,每个选项只剩三四个字的位置,模型也看不清谁是谁。项目方给的补救办法是先粗筛再精选,或者搞“分组淘汰赛”。
第三,它有点“过度自信”。 出厂状态下,它说“我有八成把握”,实际可能只有六成对。必须拿你自己的数据做一次“校准”,把它的嘴调准。这活儿不难,但不做就是坑。
还有小语种依然偏弱、打分题存在“不爱选第一个”的怪毛病等等。这些都是明牌。
所以别把它当万能锤子。它是一把很好用的螺丝刀——但前提是,你手里刚好是颗螺丝。
五、结语:不是谁干掉谁,而是“分工”重新划线
回到标题那个问题:闭源 API 还有活路吗?
我的判断是:有,但它的角色要变了。
过去两年,行业的默认动作是“有事就问大模型”。查个分类、判个真假、打个标签,也要把几千字的上下文发过去,让一个能写诗的大脑去干门卫的活。这就像请一位院士去小区门口登记访客——不是不行,是太浪费。
接下来的格局,大概率是分层:
90% 的高频、简单、格式化的判断,交给本地小模型。 快、便宜、数据不出门、还不会突然涨价或限流。
10% 真正需要推理、需要常识、需要创造力的活,交给云端大模型。 它依然是天花板,只是不再当苦力。
这波“本地化浪潮”真正动摇的,不是闭源 API 的技术优势,而是它的默认地位。当“什么都调 API”不再是唯一选项,议价权、数据主权、迭代节奏,就都回到了使用者手里。
最后留个问题给你:
如果你明天就要给公司上一套 AI 客服分流,一边是每月按量付费、开箱即用的云端 API,一边是买张显卡、自己养一个、数据不出门的小模型——你会选哪个?
再往远看一点:三年之后,你觉得那些“日常判断”里,还有多少会留在别人的服务器上?
评论区聊聊,我挺好奇大家的答案。