PaddleX 开放词汇目标检测模块实战指南:零样本文本提示驱动的检测推理
PaddleX 开放词汇目标检测模块实战指南:零样本文本提示驱动的检测推理
开放词汇目标检测(Open Vocabulary Detection,OVD)突破了传统检测器"只能识别预训练类别"的限制,允许用户通过一段自然语言文本定义任意类别,模型即可在图像中定位并识别这些"从未见过"的物体。本文以 PaddleX 的开放词汇目标检测模块为核心,完整讲解其支持模型、推理 API、阈值与 prompt 用法、结果处理以及底层预处理/后处理实现,并结合仓库源码给出可验证的配置与调用依据。读完本文,你将能够基于 GroundingDINO-T 与 YOLO-Worldv2-L 用几行代码完成零样本检测推理,并理解其文本-图像跨模态推理链路。
一、模块定位:开放词汇目标检测是什么
传统目标检测方法只能识别预定义类别集中的物体,模型一旦训练完成,类别集合便固定下来。开放词汇目标检测则允许模型识别未在训练中出现过的物体:通过结合自然语言处理技术,用文本描述来定义新类别,模型据此识别和定位图像中的新物体,从而使目标检测具备更强的灵活性与泛化能力。
在 PaddleX 中,该能力以独立的模型模块形式提供,位于 paddlex/inference/models/open_vocabulary_detection/ 目录,其推理入口由 OVDetRunnerPredictor 实现(predictor.py),与普通目标检测的关键差异在于:推理时必须额外传入 prompt 文本,预处理阶段会将图像与文本一起编码,后处理阶段再依据文本与检测框的匹配程度输出类别标签。模块同时以 Pipeline 形式集成,见 paddlex/inference/pipelines/open_vocabulary_detection/pipeline.py。
二、支持模型列表与性能基准
PaddleX 当前为开放词汇目标检测模块提供两款预训练模型,均支持推理集成。下表整理自官方教程,其中推理耗时仅包含模型推理耗时,不包含前后处理耗时:
| 模型 | 模型下载链接 | mAP(0.5:0.95) | mAP(0.5) | GPU推理耗时(ms)[常规模式 / 高性能模式] | 模型存储大小(MB) | 介绍 |
|---|---|---|---|---|---|---|
| GroundingDINO-T | 推理模型 | 49.4 | 64.4 | - / - | 658.3 | 基于 O365、GoldG、Cap4M 三个数据集训练的开放词汇目标检测模型。文本编码器采用 Bert,视觉模型整体采用 DINO,额外设计了一些跨模态融合模块,在开放词汇目标检测领域取得了较好的效果 |
| YOLO-Worldv2-L | 推理模型 | 44.4 | 59.8 | 292.14 / 292.14 | 421.4 | 基于 O365、GoldG 两个数据集训练的开放词汇目标检测模型。文本编码器采用 CLIP,视觉模型整体采用 YOLOv8,额外设计了一些轻量化的跨模态融合模块,在精度和速度之间取得了较好的均衡 |
测试环境说明:
- 性能测试环境
- 测试数据集: 基于 O365、GoldG、Cap4M 三个数据集训练的开放词汇目标检测模型。
- 硬件配置: GPU 为 NVIDIA Tesla T4;CPU 为 Intel Xeon Gold 6271C @ 2.60GHz。
- 软件环境: Ubuntu 20.04 / CUDA 11.8 / cuDNN 8.9 / TensorRT 8.6.1.6;paddlepaddle 3.0.0 / paddlex 3.0.3。
- 推理模式说明
| 模式 | GPU配置 | CPU配置 | 加速技术组合 |
|---|---|---|---|
| 常规模式 | FP32精度 / 无TRT加速 | FP32精度 / 8线程 | PaddleInference |
| 高性能模式 | 选择先验精度类型和加速策略的最优组合 | FP32精度 / 8线程 | 选择先验最优后端(Paddle/OpenVINO/TRT等) |
两款模型的官方配置文件位于 paddlex/configs/modules/open_vocabulary_detection/:其中 GroundingDINO-T.yaml 与 YOLO-Worldv2-L.yaml 均声明 mode: predict,即本模块当前仅支持预测推理,不支持训练。
三、快速集成:几行代码完成零样本检测
在快速集成前,请先安装 PaddleX 的 wheel 包,详细请参考 PaddleX本地安装教程。
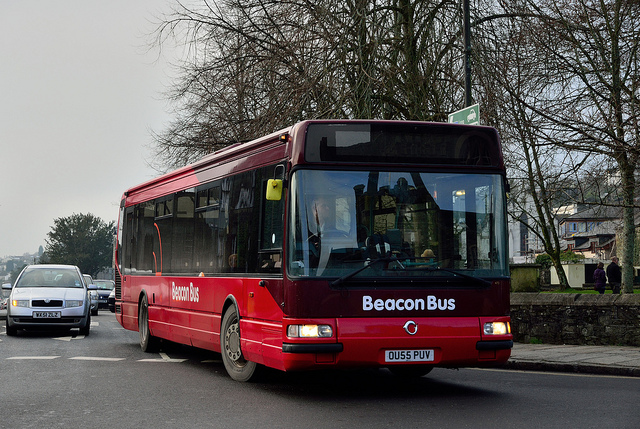
完成 whl 包安装后,几行代码即可完成开放词汇目标检测模块的推理,你可以任意切换该模块下的模型,也可以将模块的模型推理集成到自己的项目中。运行以下代码前,请先下载示例图片到本地:
from paddlex import create_model
model = create_model(model_name='GroundingDINO-T')
results = model.predict(input='open_vocabulary_detection.jpg', prompt = 'bus . walking man . rearview mirror .', batch_size=1)
for res in results:
    res.print()
    res.save_to_img(f"./output/")
    res.save_to_json(f"./output/res.json")
运行后,得到的结果为:
{'res': "{'input_path': 'open_vocabulary_detection.jpg', 'boxes': [{'coordinate': [112.10542297363281, 117.93667602539062, 514.35693359375, 382.10150146484375], 'label': 'bus', 'score': 0.9348853230476379}, {'coordinate': [264.1828918457031, 162.6674346923828, 286.8844909667969, 201.86187744140625], 'label': 'rearview mirror', 'score': 0.6022508144378662}, {'coordinate': [606.1133422851562, 254.4973907470703, 622.56982421875, 293.7867126464844], 'label': 'walking man', 'score': 0.4384709894657135}, {'coordinate': [591.8192138671875, 260.2451171875, 607.3953247070312, 294.2210388183594], 'label': 'man', 'score': 0.3573091924190521}]}"}
运行结果参数含义如下:
input_path:表示输入待预测图像的路径boxes:每个预测出的 object 的信息label:类别名称score:预测得分coordinate:预测框的坐标,格式为[xmin, ymin, xmax, ymax]
从示例输出可以看到:即使 prompt 中只写了 bus、walking man、rearview mirror 三类,模型还能输出 man 这一未显式指定的相关类别,这正是"开放词汇"能力的直观体现。
四、create_model 实例化参数详解
create_model 用于实例化开放词汇目标检测模型(此处以 GroundingDINO-T 为例),具体说明如下:
| 参数 | 参数说明 | 参数类型 | 可选项 | 默认值 |
|---|---|---|---|---|
model_name |
模型名称 | str |
无 | 无 |
model_dir |
模型存储路径 | str |
无 | 无 |
device |
模型推理设备 | str |
支持指定GPU具体卡号,如 gpu:0,其他硬件具体卡号,如 npu:0,CPU 如 cpu |
gpu:0 |
use_hpip |
是否启用高性能推理插件 | bool |
无 | False |
hpi_config |
高性能推理配置 | dict | None |
无 | None |
thresholds |
模型使用的过滤阈值 | dict/None |
无 | None |
其中:
model_name必须指定。指定model_name后,默认使用 PaddleX 内置的模型参数;在此基础上再指定model_dir时,则使用用户自定义的模型。thresholds为模型使用的过滤阈值,默认为None,表示沿用上一层设置。参数设置的优先级从高到低为:predict参数传入 >create_model初始化传入 > yaml 配置文件设置。- GroundingDINO 系列模型在推理时需要设置两个阈值:
box_threshold(默认 0.3)与text_threshold(默认 0.25),参数传入形式为{"box_threshold": 0.3, "text_threshold": 0.25}。这两个默认值与 GroundingDINO-T.yaml 及后处理器GroundingDINOPostProcessor的初始化参数(groundingdino_processors.py)保持一致。
- GroundingDINO 系列模型在推理时需要设置两个阈值:
五、predict() 方法与 prompt 提示词用法
调用开放词汇目标检测模型的 predict() 方法进行推理预测,其参数有 input、batch_size、thresholds 和 prompt,具体说明如下:
| 参数 | 参数说明 | 参数类型 | 可选项 | 默认值 |
|---|---|---|---|---|
input |
待预测数据,支持多种输入类型 | Python Var/str/list |
- Python变量,如 numpy.ndarray 表示的图像数据- 文件路径,如图像文件的本地路径: /root/data/img.jpg- URL链接,如图像文件的网络 URL:示例 - 本地目录,该目录下需包含待预测数据文件,如本地路径: /root/data/- 列表,列表元素需为上述类型数据,如 [numpy.ndarray, numpy.ndarray]、["/root/data/img1.jpg", "/root/data/img2.jpg"]、["/root/data1", "/root/data2"] |
无 |
batch_size |
批大小 | int |
任意整数 | 1 |
thresholds |
模型使用的过滤阈值 | dict/None |
- None,表示沿用上一层设置,参数设置优先级从高到低为:predict 参数传入 > create_model 初始化传入 > yaml 配置文件设置- dict,如 {"box_threshold": 0.3, "text_threshold": 0.25},表示推理时 box_threshold 设置为 0.3,text_threshold 设置为 0.25 |
None |
prompt |
模型预测使用的提示词 | str |
任意字符串 | 无 |
5.1 prompt 的写法差异:点号分隔 vs 逗号分隔
prompt 的书写格式与所选模型强相关,两种模型的文本解析逻辑在源码中有明确差异:
- GroundingDINO 系列:prompt 使用点号分隔类别短语,并以点号结尾,如
'bus . walking man . rearview mirror .'。从源码看,文本处理器GroundingDinoTextProcessor.pre_caption会对输入文本做strip(),并在末尾缺少.时自动补上(groundingdino_processors.py);随后 BERT Tokenizer 以<a href="https://link.gitcode.com/i/eb008b27f063677e2259926ccfbd7b3b" target="_blank">CLS]、[SEP]、.、?作为特殊 token 切分短语并构造文本自注意力掩码([groundingdino_processors.py)。 - YOLO-World 系列:prompt 使用逗号分隔类别,如
'bus, car, rearview mirror'(见 YOLO-Worldv2-L.yaml)。源码中的YOLOWorldProcessor.process_text会对文本做strip().lower(),再按逗号切分得到词列表,交由 CLIP Tokenizer 编码(yoloworld_processors.py)。
5.2 阈值生效机制
predict 传入的 thresholds 与初始化时传入的 thresholds 通过 OVDetRunnerPredictor._parse_current_thresholds 合并:它先扫描后处理函数签名中所有含 threshold 的参数名,再依次用初始化阈值、本次推理阈值覆盖,因此**predict 级别的阈值优先级最高**(predictor.py)。
六、预测结果的处理与导出
对预测结果进行处理时,每个样本的预测结果均为对应的 Result 对象(开放词汇检测复用目标检测的 DetResult,定义见 paddlex/inference/models/object_detection/result.py),支持打印、保存为图片、保存为 json 文件:
| 方法 | 方法说明 | 参数 | 参数类型 | 参数说明 | 默认值 |
|---|---|---|---|---|---|
print() |
打印结果到终端 | format_json |
bool |
是否对输出内容使用 JSON 缩进格式化 |
True |
indent |
int |
指定缩进级别,以美化输出的 JSON 数据,使其更具可读性,仅当 format_json 为 True 时有效 |
4 | ||
ensure_ascii |
bool |
控制是否将非 ASCII 字符转义为 Unicode。设置为 True 时所有非 ASCII 字符将被转义;False 则保留原始字符,仅当 format_json 为 True 时有效 |
False |
||
save_to_json() |
将结果保存为 json 格式的文件 | save_path |
str |
保存的文件路径,当为目录时,保存文件命名与输入文件类型命名一致 | 无 |
indent |
int |
指定缩进级别,以美化输出的 JSON 数据,使其更具可读性,仅当 format_json 为 True 时有效 |
4 | ||
ensure_ascii |
bool |
控制是否将非 ASCII 字符转义为 Unicode。设置为 True 时所有非 ASCII 字符将被转义;False 则保留原始字符,仅当 format_json 为 True 时有效 |
False |
||
save_to_img() |
将结果保存为图像格式的文件 | save_path |
str |
保存的文件路径,当为目录时,保存文件命名与输入文件类型命名一致 | 无 |
此外,也支持通过属性获取带结果的可视化图像和预测结果:
| 属性 | 属性说明 |
|---|---|
json |
获取预测的 json 格式的结果 |
img |
获取格式为 dict 的可视化图像 |
七、源码级原理:图像-文本跨模态推理管线
从源码结构看,OVDetRunnerPredictor 的推理链路(predictor.py)为:ReadImage → 图像预处理算子 → 模型专属 Processor(拼接文本)→ runner 推理 → 后处理。核心差异体现在两个 Processor 上:
GroundingDINO 预处理(groundingdino_processors.py)
- 文本侧:加载模型目录
tokenizer/下的 BERT Tokenizer,对 prompt 分词并构造input_ids、attention_mask、position_ids、text_self_attention_masks等文本输入,最大词数text_max_words默认为 256; - 图像侧:保持宽高比缩放到
(800, 1333)目标尺寸(短边 800、长边上限 1333),使用 ImageNet 统计的均值方差[0.485, 0.456, 0.406]/[0.229, 0.224, 0.225]归一化,并以nested_tensor形式处理 batch 内不同尺寸图像的 padding。
YOLO-World 预处理(yoloworld_processors.py)
- 文本侧:加载 CLIP Tokenizer,prompt 按逗号切词;
- 图像侧:通过
LetterResize将图像统一缩放至(640, 640)(同时记录scale_factor与pad_param,用于后处理还原坐标),图像像素除以 255 后按均值[0.0, 0.0, 0.0]、方差[1.0, 1.0, 1.0]归一化。
后处理差异
- GroundingDINO 的后处理
GroundingDINOPostProcessor对每个检测框先按box_threshold过滤低置信度框,再通过text_threshold判断该框命中了 prompt 中的哪些词,从而解码出类别标签(groundingdino_processors.py); - YOLO-World 的后处理
YOLOWorldPostProcessor则按单一threshold(默认 0.05)过滤,根据网络输出的类别索引映射回 prompt 词列表,并将坐标裁剪回原图尺寸(yoloworld_processors.py)。
八、Pipeline 方式与服务化部署
除了直接使用模型,PaddleX 还将开放词汇目标检测封装为 Pipeline。Pipeline 配置见 paddlex/configs/pipelines/open_vocabulary_detection.yaml,其中 SubModules.OpenVocabularyDetection 默认选用 GroundingDINO-T,batch_size 为 1,默认阈值 box_threshold: 0.3、text_threshold: 0.25。对应的 Pipeline 实现类 OpenVocabularyDetectionPipeline(pipeline.py)在其 predict() 中要求同时传入 input 与 prompt,并将阈值解析后透传给底层模型。
若需以 HTTP 服务方式对外提供能力,PaddleX 的 serving 层已注册了名为 /open-vocabulary-detection 的推理端点(serving/schemas/open_vocabulary_detection.py),请求体包含 image、prompt、thresholds 与 visualize 字段,响应中返回 detectedObjects(含边界框 bbox、类别 categoryName、置信度 score)以及可选的可视化图像 image。
九、二次开发现状
需要明确的是:当前模块暂时不支持微调训练,仅支持推理集成。关于该模块的微调训练,PaddleX 计划在未来版本中支持。因此当前适合的使用方式为:直接使用内置的 GroundingDINO-T / YOLO-Worldv2-L 预训练权重,通过 prompt 文本在推理阶段自由定义检测类别,并将其集成到自身业务系统中。
关于更多 PaddleX 单模型推理的 API 使用方法,可以参考 PaddleX单模型Python脚本使用说明。