一次塞10张参考图,AI把它们拼成一张照片:阿里新开源生图模型 Qwen-Image-2.1 大白话解读
一次塞10张参考图,AI把它们拼成一张照片:阿里新开源生图模型 Qwen-Image-2.1 大白话解读
最近几天,AI 生图圈有点热闹。
9 月 20 日,阿里 Qwen 团队开源了图像模型 Qwen-Image-2.1,发布没几天,快科技、智东西等媒体直接给它扣上“7B 小模型超越闭源”“拿下开源生图第一”的帽子。
热度最高的一个参数是:最多支持 10 张参考图。
啥概念?通俗讲,就是你可以一口气甩给它最多 10 张照片,再用一句话说明白想干嘛,它能把这些照片“拼”成一张全新的图。
家里人每人拍张照,AI 给你出一张“全家福”;电商的模特、衣服、鞋子、包、帽子各来一张,AI 直接合成一张完整穿搭展示图;漫画里的主角三视图丢进去,它能接着画出一整页分镜。
别急,咱们用大白话一层层拆。
一、这“能塞 10 张图的 AI”到底是个啥
一句话:一个“生成和编辑统一”的开源 AI——文生图能干、改图能干,连透明底的图片都能原生画出来。
这次版本最大的变化是“更轻、更强”。上一代 Qwen-Image 的生成引擎有 20B 参数,显存要求不低;这次视觉生成部分瘦身到 7B,配合一套“看一次参考材料就记下笔记”的缓存机制,同样的画质下速度明显更快,对显卡的要求也友好得多。
可以理解成:以前得用大卡车拉货,现在换了一辆装载效率更高的小货车,跑得更快,停车的地方还不用那么大。
“大脑”部分则沿用了能看图又能读字的 Qwen3-VL 8B 模型。这个大脑,正是“10 张参考图”这套超能力的关键,下面细说。
二、单图编辑和多图参考,是两条完全不同的路
很多人会问:AI 改图早就有了,这有啥新鲜的?
差别很大,打个比方。
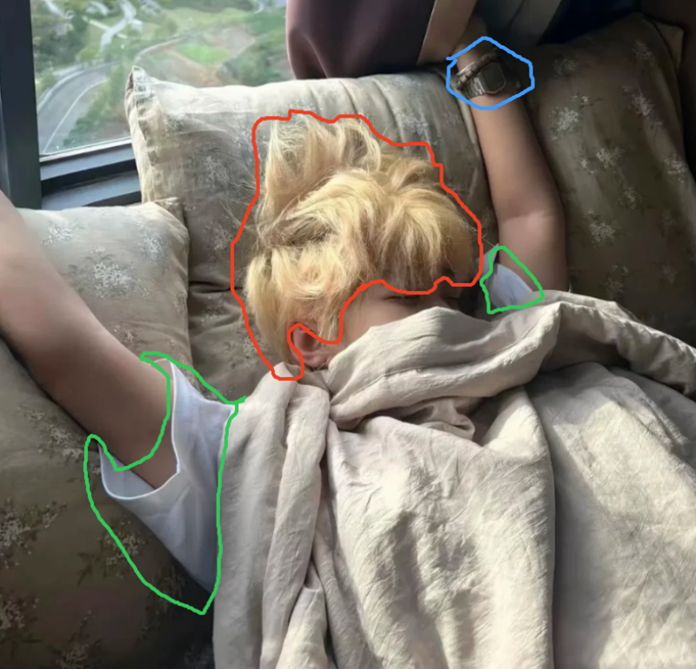
单图编辑,像一位修图师:你递给他一张照片,说“把背景换成海滩”,他就在这张图的基础上微调。Qwen-Image-2.1 这方面也很强,还支持“圈哪里改哪里”——你在照片上圈一下,说“把这个表去掉”,就只动那一块,别的纹丝不动。
多图参考,则像搭电影剧组:一张照片是“演员”,一张是“服装”,一张是“布景参考”,还有一张是“打光风格参考”。AI 是导演,它把所有素材都“审阅”一遍,然后按剧本拍出一整场全新的戏。
出来的不再是对旧图的微调,而是一张全新的图。
所以多图参考真正有用的地方在于:你要的不是“修过的旧照”,而是“一张本来不存在的新图”。
三、10 张图怎么协作?背后的秘密拆开看
机制其实不复杂,拆成三步就能听懂。
第一,把素材“翻译成同一种语言”。
它的大脑(Qwen3-VL 8B)既能读文字又能看图,会把你的文字指令和 10 张照片统统转成同一种“工作语言”。
这样一来,在模型眼里,“让第 1 张图的人穿上第 2 张图的衣服”和“背景放海滩”就是一锅里的素材:10 张图加 1 句指令,按剧本混搭。文字和图片终于站在了同一起跑线上。
第二,素材只看一遍,记笔记后干活。
生图这件事,本质是几十轮的“慢慢打磨”,官方默认要 40 步才能从模糊变清晰。
如果每一轮都把 10 张参考图重新“读”一遍,那会慢得没法用。Qwen-Image-2.1 的巧妙之处在于:它先把参考图和指令理解一次、存成笔记,后面 40 轮打磨全程看笔记就够了。
这就是“敢放 10 张图、却不会慢 10 倍”的根本原因。
第三,一张“数字演员合同”:脸不走样。
官方特别强调:人物和产品的身份保持。意思是,不管场景怎么变,参考图里的人脸、产品外观都保持原样。
对电商和做个人 IP 的人来说,这一点就是命门。
顺带给几条实用小技巧:
- 给每张图分好“角色”,指令里用“第 1 张、第 2 张”明确指代,说得越清楚越稳;
- 最重要的主角图,尽量排在前面;
- 别盲目堆图,3 到 5 张聚焦的素材往往比 10 张杂图效果更好,真的大场景再往上加;
- 懒得写长指令?官方配套了“提示词扩写”小工具,你写个短句,它自动帮你扩成详细剧本。
四、真实场景:普通人最想干的那几件事
1、电商合成:5 张图 = 1 张完整展示图
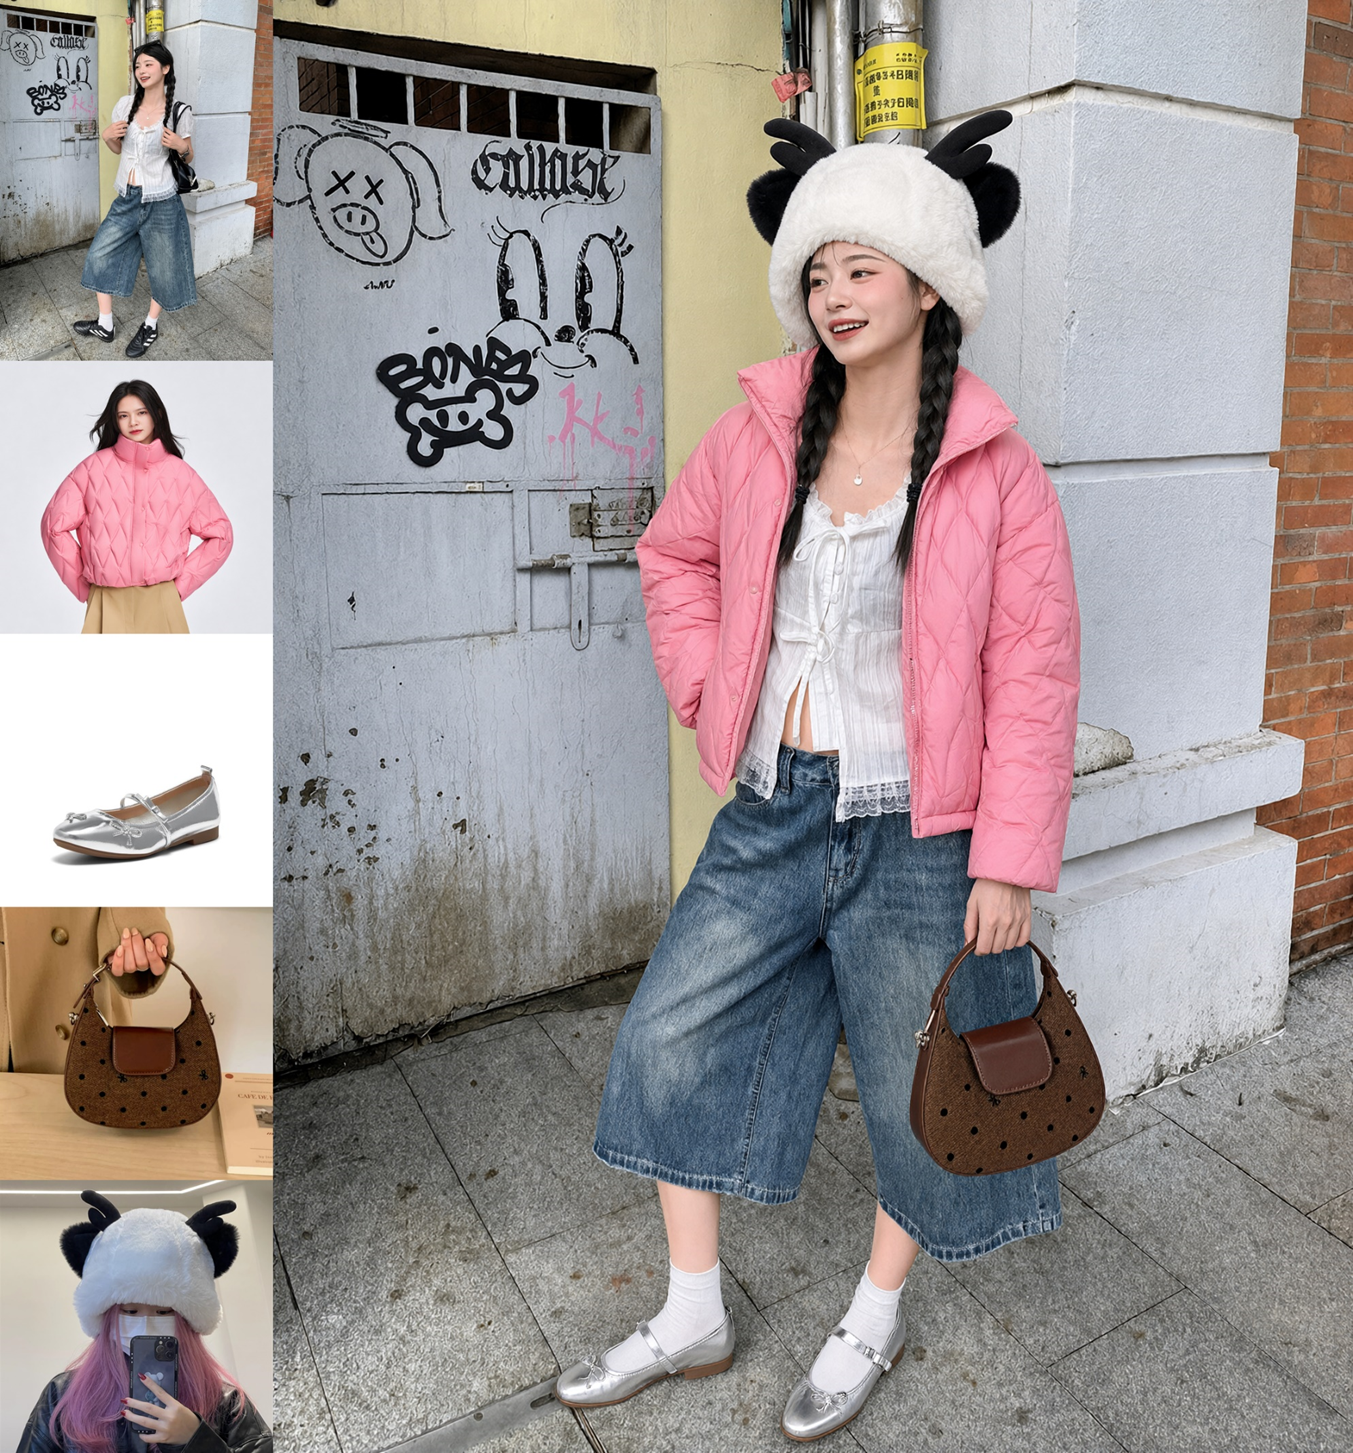
官方给的例子就是一套完整穿搭:模特、衣服、鞋子、包、帽子各一张,5 张图进去,出来的是一张模特上身展示图。
不雇模特、不搭棚、不用后期抠图,电商主图的成本可以说降了一个数量级。而且它还能原生生成透明底图片,商品图、贴纸直接用,省去手动抠背景。
2、合影、全家福:6 张单人照 = 1 张合影
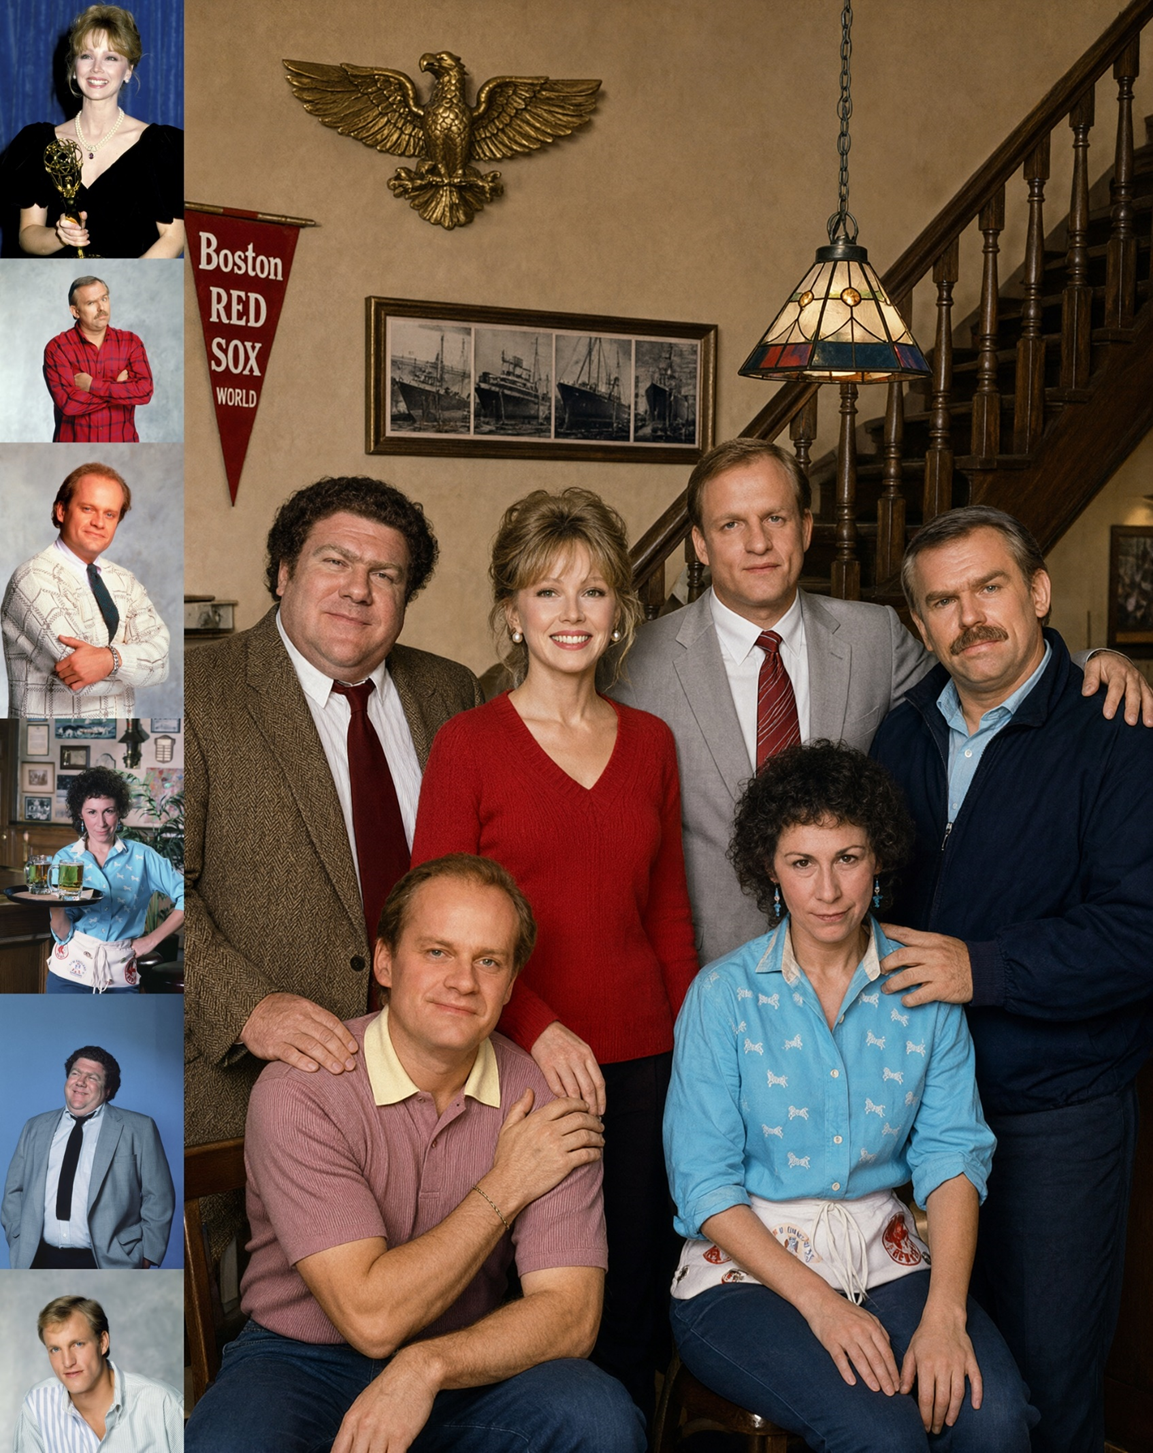
这是网友讨论度最高的场景:6 个人凑不齐、或者相隔千里,各自发一张自拍,AI 生成一张光线统一、背景统一的合影,人物五官还都是本人的。
3、剧情插画:角色一整页都不换脸
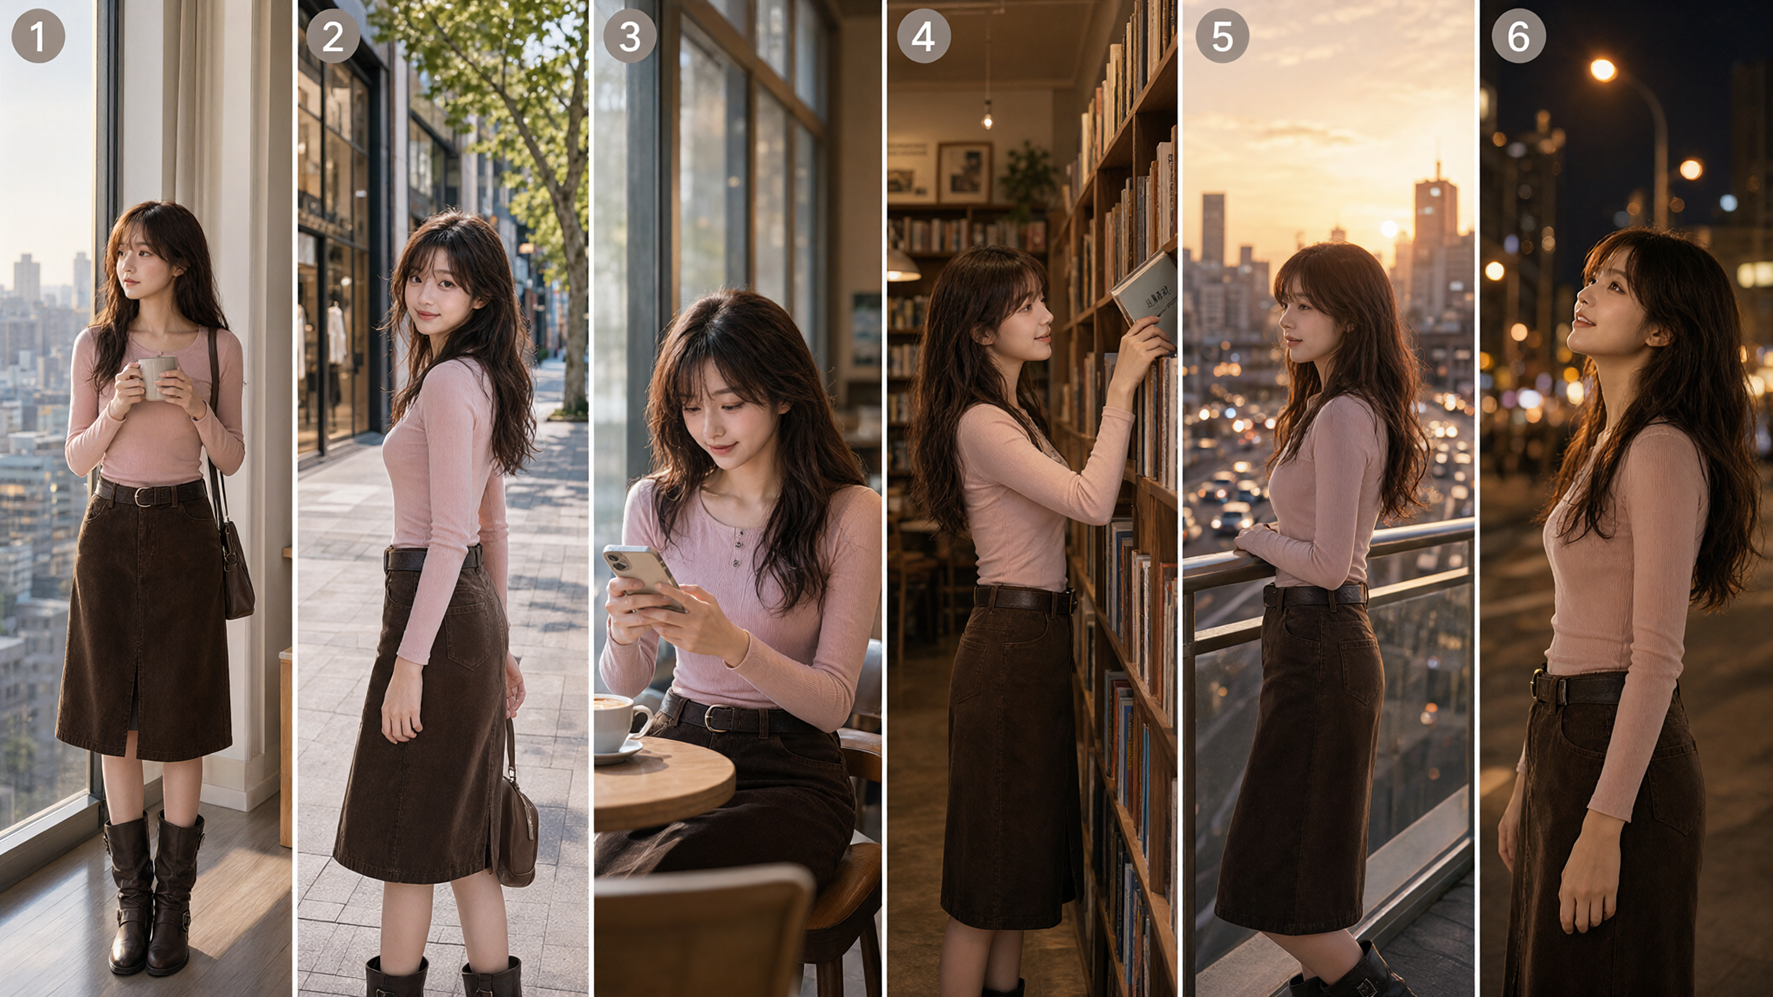
漫画和剧情插画最大的痛点一直是“角色一致性”——第一页脸长这样,第二页像换了个人。现在给它一张角色三视图,它能直接画出整页分镜,脸全程稳得住。
另外它“最会写中文”也是出了名的,海报里的汉字不扭不歪,对中文创作者格外友好。
五、普通人怎么上手?门槛高吗
好消息是,这次的门槛真的不高:
- 没显卡、不想折腾:有官方在线 Demo 可以直接玩;国内用户用 wuli.art 就能免费体验全部功能,包括透明图生成;
- ComfyUI 玩家:官方首发当天就适配,模板工作流直接导入就能用;
- 本地部署:7B 轻量化设计,普通消费级显卡也能跑;显存不够时,官方自带“内存节省模式”,会自动把模型拆一部分放到内存里;
- 追求速度:10 月 9 日官方又放出了 Turbo 版,8 步出一张图,而标准版要 40 步,速度快了好几条街,连苹果芯片的 Mac 上都有对应的应用能跑;
- 国产硬件:沐曦等芯片厂商完成了首日适配,英特尔显卡和核显通过官方工具链也能跑。
适合谁?电商运营、自媒体创作者、设计师、漫画作者,以及所有爱折腾开源模型的人。只要你的日常需求里有“合图、角色一致、改图”中的任意一条,就值得一试。
六、写在最后
Qwen-Image-2.1 火,不只是因为效果好。
它释放了一个信号:多图参考、角色一致这些能力,正在从大厂闭源平台的“付费特权”,变成普通人桌面上可以免费把玩的东西。 从显卡到国产芯片,整个生态链首发当天就跟进适配,说明行业对它的分量心里有数。
最后抛个问题:如果 AI 能把 10 张参考图拼成一张照片,你最想合成的是哪张?
是一张全家福、一个换装主角,还是你同事们的“团队大合影”?评论区聊聊。