PaddleX 开放词汇检测产线实战指南:零训练实现任意类别目标检测
PaddleX 开放词汇检测产线实战指南:零训练实现任意类别目标检测
开放词汇目标检测(Open Vocabulary Detection)允许模型识别训练阶段从未见过的物体类别,只需通过文本提示词描述类别即可完成检测与定位。本文以 PaddleX 通用开放词汇检测产线(open_vocabulary_detection)为对象,系统讲解其技术原理、内置模型与基准数据、CLI 与 Python 双入口快速上手、结果解析与保存、配置文件定制,以及服务化部署、高性能推理和端侧部署的完整方案。读完本文,你将掌握如何在不训练、不微调的前提下,用一句文本提示词驱动 GroundingDINO-T 等开放词汇模型完成任意类别的目标检测,并将其集成进自己的业务系统。
1. 开放词汇检测产线介绍
1.1 技术背景:从封闭词表到开放词汇
传统目标检测模型通常在一个固定的、预定义的类别集合上训练,模型只能识别训练时见过的类别,一旦部署场景中出现新类别,就必须重新采集数据、重新训练,成本高、迭代慢。开放词汇目标检测(Open-Vocabulary Object Detection, OVD)则突破了这一限制:它借助自然语言处理技术,用文本描述来定义新类别,模型据此在图像中识别并定位这些从未在训练中出现的物体,从而大幅提升目标检测的灵活性与泛化能力。
PaddleX 的通用开放词汇检测产线将这一能力封装为开箱即用的产品级方案:只需提供一张图像和一句提示词(如 "bus . walking man . rearview mirror ."),即可得到每个目标类别、置信度分数和边界框坐标。该产线同时提供灵活的服务化部署方式,支持在多种硬件上使用多种编程语言调用。需要说明的是,当前产线暂不支持对模型的二次开发(微调训练),仅支持推理集成,微调能力计划在未来版本中支持。
1.2 产线组成与模型选择
通用开放词汇检测产线由一个开放词汇检测模块构成,目前提供两个可选模型:GroundingDINO-T 与 YOLO-Worldv2-L(后者已在配置目录中提供,详见 paddlex/configs/modules/open_vocabulary_detection/)。产线默认加载 GroundingDINO-T,其默认配置见 paddlex/configs/pipelines/open_vocabulary_detection.yaml。
通用图像开放词汇检测模块(可选):
| 模型 | mAP(0.5:0.95) | mAP(0.5) | GPU推理耗时(ms)[常规模式 / 高性能模式] | CPU推理耗时(ms)[常规模式 / 高性能模式] | 模型存储大小(MB) | 介绍 |
|---|---|---|---|---|---|---|
| GroundingDINO-T | 49.4 | 64.4 | - / - | - / - | 658.3 | 基于 O365、GoldG、Cap4M 三个数据集训练的开放词汇目标检测模型。文本编码器采用 Bert,视觉模型部分整体采用 DINO,并额外设计了跨模态融合模块,在开放词汇目标检测领域取得了较好的效果 |
说明:上表为当前仓库中文文档中给出的基准数据;英文文档给出的模型下载链接指向
paddle3.0b2版本,以实际可用链接为准。选择模型时,可遵循“重精度选高 mAP、重速度选低耗时、重存储选小体积”的通用策略。
测试环境说明:
-
性能测试环境
- 测试数据集:COCO val2017 验证集
- 硬件配置:
- GPU:NVIDIA Tesla T4
- CPU:Intel Xeon Gold 6271C @ 2.60GHz
- 其他环境:Ubuntu 20.04 / CUDA 11.8 / cuDNN 8.9 / TensorRT 8.6.1.6
-
推理模式说明
| 模式 | GPU配置 | CPU配置 | 加速技术组合 |
|---|---|---|---|
| 常规模式 | FP32精度 / 无TRT加速 | FP32精度 / 8线程 | PaddleInference |
| 高性能模式 | 选择先验精度类型和加速策略的最优组合 | FP32精度 / 8线程 | 选择先验最优后端(Paddle/OpenVINO/TRT等) |
1.3 从源码看产线内部结构
产线的执行链路在源码中非常清晰。入口类是 paddlex/inference/pipelines/open_vocabulary_detection/pipeline.py 中的 OpenVocabularyDetectionPipeline,它:
- 通过装饰器
@pipeline_requires_extra("multimodal")声明该产线依赖multimodal依赖分组(这就是安装文档中强调要按multimodal分组安装依赖的原因); - 初始化时从配置的
SubModules.OpenVocabularyDetection字段读取模型配置并调用create_model创建底层模型,同时读取默认thresholds; predict()方法是一个生成器,将input、prompt、thresholds直接透传给底层模型推理。
底层模型侧,paddlex/inference/models/open_vocabulary_detection/predictor.py 中的 OVDetPredictor 维护了完整的“图像读取 → 预处理 → 静态图推理 → 后处理”流水线:预处理栈由 ReadImage(format="RGB") 与模型专属 Processor 组成;后处理依据模型名自动选择 GroundingDINOPostProcessor(box_threshold/text_threshold)或 YOLOWorldPostProcessor(单一 threshold)。阈值解析逻辑 _parse_current_thresholds 会按“predict 调用时传入 > 初始化默认值”的优先级合并阈值,这正是调用时传参可覆盖配置文件默认值的底层实现依据。
2. 快速开始
2.1 本地体验
❗ 在本地使用通用开放词汇检测产线前,请确保已按照 PaddleX 本地安装教程 完成 PaddleX wheel 包安装。若希望选择性安装依赖,请参考安装教程中的相关说明。该产线对应的依赖分组为
multimodal。
2.1.1 命令行方式体验
一行命令即可快速体验开放词汇检测产线效果。使用测试文件,并将 --input 替换为本地路径进行预测:
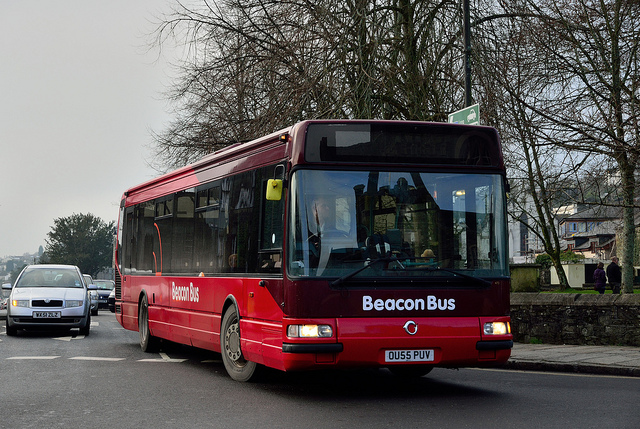
paddlex --pipeline open_vocabulary_detection \
        --input open_vocabulary_detection.jpg \
        --prompt "bus . walking man . rearview mirror ." \
        --thresholds "{'text_threshold': 0.25, 'box_threshold': 0.3}" \
        --save_path ./output \
        --device gpu:0
参数含义:--pipeline 指定产线名称;--input 为待预测图像路径;--prompt 为文本提示词,描述需要检测的类别;--thresholds 为推理阈值(JSON 格式字典);--save_path 为结果保存目录;--device 指定推理设备,如 gpu:0、npu:0 或 cpu。相关参数说明可参考 2.1.2 Python 脚本方式集成 中的参数说明。
运行后,会将结果打印到终端,结果如下:
{'res': {'input_path': 'open_vocabulary_detection.jpg', 'page_index': None, 'boxes': [{'coordinate': [112.10542297363281, 117.93667602539062, 514.35693359375, 382.10150146484375], 'label': 'bus', 'score': 0.9348853230476379}, {'coordinate': [264.1828918457031, 162.6674346923828, 286.8844909667969, 201.86187744140625], 'label': 'rearview mirror', 'score': 0.6022508144378662}, {'coordinate': [606.1133422851562, 254.4973907470703, 622.56982421875, 293.7867126464844], 'label': 'walking man', 'score': 0.4384709894657135}, {'coordinate': [591.8192138671875, 260.2451171875, 607.3953247070312, 294.2210388183594], 'label': 'man', 'score': 0.3573091924190521}]}}
运行结果参数说明可参考 2.1.2 Python 脚本方式集成 中的结果解释。可视化结果保存在 save_path 下。
2.1.2 Python 脚本方式集成
命令行适合快速体验;在实际项目中通常需要代码集成。通过几行代码即可完成产线的快速推理:
from paddlex import create_pipeline

pipeline = create_pipeline(pipeline="open_vocabulary_detection")

output = pipeline.predict(input="open_vocabulary_detection.jpg", prompt="bus . walking man . rearview mirror .")

for res in output:
    res.print()
    res.save_to_img(save_path="./output/")
    res.save_to_json(save_path="./output/")
在上述 Python 脚本中,依次执行了三个关键步骤:
(1)通过 create_pipeline() 实例化开放词汇检测产线对象
| 参数 | 参数说明 | 参数类型 | 默认值 |
|---|---|---|---|
pipeline |
产线名称或产线配置文件路径。若为产线名称,则必须是 PaddleX 所支持的产线 | str |
None |
config |
产线具体的配置信息(若与 pipeline 同时设置,优先级高于 pipeline,且要求产线名与 pipeline 一致) |
dict[str, Any] |
None |
device |
产线推理设备。支持指定 GPU 具体卡号如 gpu:0,其他硬件具体卡号如 npu:0,CPU 如 cpu |
str |
None |
use_hpip |
是否启用高性能推理插件。若为 None,则使用配置文件或 config 中的配置 |
bool | None |
None |
hpi_config |
高性能推理配置 | dict | None |
None |
(2)调用产线对象的 predict() 方法进行推理预测
该方法返回一个 generator。各参数说明如下:
| 参数 | 参数说明 | 参数类型 | 可选项 | 默认值 |
|---|---|---|---|---|
input |
待预测数据,支持多种输入类型,必填 | Python Var | str | list |
Python Var:如 numpy.ndarray 表示的图像数据;str:如图像文件或 PDF 文件的本地路径 /root/data/img.jpg、网络 URL 链接、或包含待预测图像的本地目录 /root/data/(当前不支持目录中包含 PDF 文件的预测,PDF 需指定到具体文件路径);List:列表元素须为上述类型,如 [numpy.ndarray, numpy.ndarray]、["/root/data/img1.jpg", "/root/data/img2.jpg"]、["/root/data1", "/root/data2"] |
None |
thresholds |
模型推理时使用的阈值 | dict[str, float] |
dict[str, float]:key 为 str 代表阈值名,value 为 0 到 1 之间的浮点数代表阈值大小。如 GroundingDINO 对应设置为 {"text_threshold": 0.25, "box_threshold": 0.3},表示文本阈值 0.25、检测框阈值 0.3 |
无 |
prompt |
模型推理时使用的提示词 | str |
str:需结合具体模型设定。如 GroundingDINO 对应提示词格式为 "{类别1} . {类别2} . {类别3} ." |
无 |
阈值的作用原理(源码级):以 GroundingDINO 为例,在 paddlex/inference/models/open_vocabulary_detection/processors/groundingdino_processors.py 的
GroundingDINOPostProcessor.postprocess中,box_threshold用于对每个检测框按 logits 最大值做低置信度过滤(filt_mask = logits_filt.max(axis=1) > box_threshold),text_threshold用于在过滤后的 logits 上通过decode(logit > text_threshold, src_prompt)反推出该框对应的文本短语标签。也就是说,提高box_threshold可减少误检框,提高text_threshold会让标签判定更保守。若使用 YOLO-Worldv2-L 模型,后处理只使用单一的threshold(默认 0.05),且提示词按逗号分隔类别(见YOLOWorldProcessor.process_text中的text.split(",")),两者不可混用。
(3)对预测结果进行处理
每个样本的预测结果均为对应的 Result 对象,支持打印、保存为图片、保存为 json 文件:
| 方法 | 方法说明 | 参数 | 参数类型 | 参数说明 | 默认值 |
|---|---|---|---|---|---|
print() |
打印结果到终端 | format_json |
bool |
是否对输出内容进行 JSON 缩进格式化 | True |
indent |
int |
指定缩进级别以美化 JSON 输出,仅当 format_json 为 True 时有效 |
4 | ||
ensure_ascii |
bool |
控制是否将非 ASCII 字符转义为 Unicode。True 时全部转义,False 保留原字符,仅当 format_json 为 True 时有效 |
False |
||
save_to_json() |
将结果保存为 json 格式文件 | save_path |
str |
保存的文件路径,为目录时保存文件命名与输入文件类型命名一致 | 无 |
indent |
int |
指定缩进级别以美化 JSON 输出,仅当 format_json 为 True 时有效 |
4 | ||
ensure_ascii |
bool |
控制是否将非 ASCII 字符转义为 Unicode。True 时全部转义,False 保留原字符,仅当 format_json 为 True 时有效 |
False |
||
save_to_img() |
将结果保存为图像格式文件 | save_path |
str |
保存的文件路径,支持目录或文件路径 | 无 |
-
调用
print()方法会将结果打印到终端,打印内容解释如下:input_path:(str)待预测图像的输入路径page_index:(Union[int, None])若输入为 PDF 文件,表示当前是 PDF 的第几页,否则为Noneboxes:(list)检测框信息,每个元素为一个字典,包含以下字段:label:(str)类别名称score:(float)置信度coordinate:(list)检测框坐标,格式为[xmin, ymin, xmax, ymax]
-
调用
save_to_json()方法会将上述内容保存到指定save_path。若指定为目录,保存路径为save_path/{your_img_basename}_res.json;若指定为文件,则直接保存到该文件。由于 json 文件不支持保存 numpy 数组,其中的numpy.array类型会被转换为列表形式。 -
调用
save_to_img()方法会将可视化结果保存到指定save_path。若指定为目录,保存路径为save_path/{your_img_basename}_res.{your_img_extension};若指定为文件,则直接保存到该文件。
此外,还支持通过属性获取带结果的可视化图像和预测结果:
| 属性 | 属性说明 |
|---|---|
json |
获取预测的 json 格式结果 |
img |
获取格式为 dict 的可视化图像 |
json属性获取的预测结果为 dict 类型数据,内容与调用save_to_json()方法保存的内容一致。img属性返回的预测结果是一个字典类型数据,其中键为res,对应的值是一个Image.Image对象,用于展示开放词汇检测的预测结果。
2.2 配置文件获取与自定义加载
除直接使用产线名称外,还可以获取开放词汇检测产线配置文件,并加载配置文件进行预测。执行如下命令可将结果保存在 my_path 中:
paddlex --get_pipeline_config open_vocabulary_detection --save_path ./my_path
获取配置文件后,即可对开放词汇检测产线各项配置进行自定义,只需将 create_pipeline 方法中的 pipeline 参数值改为产线配置文件路径即可:
from paddlex import create_pipeline

pipeline = create_pipeline(pipeline="./my_path/open_vocabulary_detection.yaml")

output = pipeline.predict(
    input="./open_vocabulary_detection.jpg",
    thresholds={"text_threshold": 0.25, "box_threshold": 0.3},
    prompt="cat . dog . bird ."
)

for res in output:
    res.print()
    res.save_to_img("./output/")
    res.save_to_json("./output/")
配置文件解析:仓库内置的产线默认配置文件为 paddlex/configs/pipelines/open_vocabulary_detection.yaml,内容如下:
pipeline_name: open_vocabulary_detection

SubModules:
  OpenVocabularyDetection:
    module_name: open_vocabulary_detection
    model_name: GroundingDINO-T
    model_dir: null
    batch_size: 1
    thresholds:
      box_threshold: 0.3
      text_threshold: 0.25
各字段含义:
pipeline_name:产线名称,须与create_pipeline指定的名称一致;SubModules.OpenVocabularyDetection.module_name:子模块名;model_name:使用的开放词汇检测模型,默认GroundingDINO-T,可替换为YOLO-Worldv2-L;model_dir:本地模型目录,为null时自动下载官方推理模型;batch_size:批大小,默认 1;thresholds:初始化默认阈值,box_threshold(检测框阈值)默认 0.3,text_threshold(文本阈值)默认 0.25。这组默认值在OpenVocabularyDetectionPipeline.__init__中被读取,并在predict调用时被显式传入的thresholds覆盖。
注:配置文件中的参数为产线初始化参数。若希望更改通用开放词汇检测产线初始化参数,可直接修改配置文件中的参数并加载配置文件进行预测。同时,CLI 预测也支持传入配置文件,用
--pipeline指定配置文件路径即可。
从源码结构看,模块级配置(paddlex/configs/modules/open_vocabulary_detection/GroundingDINO-T.yaml 与 YOLO-Worldv2-L.yaml)进一步给出了模型级可调参数:GroundingDINO 预处理默认 text_max_words=256、图像 target_size=(800, 1333),并使用 ImageNet 统计的归一化均值/方差;YOLO-World 预处理默认图像尺寸 (640, 640),文本按逗号分隔类别(详见 paddlex/inference/models/open_vocabulary_detection/processors/yoloworld_processors.py)。需要说明的是,YOLO-Worldv2-L 已出现在模块配置目录中,但其正式基准数据与发布状态以官方模型列表(paddlex/utils/official_models.py)为准。
3. 开发集成与部署
如果产线可以达到你对推理速度和精度的要求,可以直接进行开发集成/部署。若需将产线直接应用到 Python 项目中,参考 2.1.2 Python 脚本方式 中的示例代码即可。
此外,PaddleX 还提供了以下三种部署方式:
3.1 🚀 高性能推理
在实际生产环境中,许多应用对部署策略的性能指标(尤其是响应速度)有较严苛的标准。PaddleX 提供高性能推理插件,对模型推理及前后处理进行深度性能优化,实现端到端流程的显著提速。create_pipeline 中的 use_hpip 与 hpi_config 参数即用于控制高性能推理插件的启用与配置。详细流程请参考 PaddleX 高性能推理指南。
3.2 ☁️ 服务化部署
服务化部署是实际生产环境中常见的一种部署形式:将推理功能封装为服务,客户端通过网络请求访问服务获取推理结果。PaddleX 支持多种产线服务化部署方案,详细流程请参考 PaddleX 服务化部署指南。
以下是基础服务化部署的 API 参考与多语言服务调用示例:
API 参考
服务提供的主要操作:
- HTTP 请求方法为 POST;
- 请求体和响应体均为 JSON 数据(JSON 对象);
- 请求处理成功时,响应状态码为
200,响应体属性如下:
| 名称 | 类型 | 含义 |
|---|---|---|
logId |
string |
请求的 UUID |
errorCode |
integer |
错误码,固定为 0 |
errorMsg |
string |
错误说明,固定为 "Success" |
result |
object |
操作结果 |
请求处理未成功时,响应体属性如下:
| 名称 | 类型 | 含义 |
|---|---|---|
logId |
string |
请求的 UUID |
errorCode |
integer |
错误码,与响应状态码相同 |
errorMsg |
string |
错误说明 |
服务提供的主要操作 infer:对图像进行目标检测。
POST /open-vocabulary-detection
请求体属性如下:
| 名称 | 类型 | 含义 | 是否必填 |
|---|---|---|---|
image |
string |
服务器可访问的图像文件的 URL 或图像文件内容的 Base64 编码结果 | 是 |
prompt |
string |
预测使用的文本提示词 | 是 |
thresholds |
object | null |
模型预测使用的阈值 | 否 |
请求处理成功时,响应体的 result 具有如下属性:
| 名称 | 类型 | 含义 |
|---|---|---|
detectedObjects |
array |
目标的位置、类别等信息 |
image |
string |
目标检测结果图,JPEG 格式,Base64 编码 |
detectedObjects 中每个元素为一个 object,具有如下属性:
| 名称 | 类型 | 含义 |
|---|---|---|
bbox |
array |
目标位置,元素依次为边界框左上角 x 坐标、左上角 y 坐标、右下角 x 坐标、右下角 y 坐标 |
categoryName |
string |
目标类别名 |
score |
number |
目标得分 |
result 示例如下:
{
  "detectedObjects": [
    {
      "bbox": [404.4967956542969, 90.15770721435547, 506.2465515136719, 285.4187316894531],
      "categoryName": "bird",
      "score": 0.7418514490127563
    },
    {
      "bbox": [155.33145141601562, 81.10954284667969, 199.71136474609375, 167.4235382080078],
      "categoryName": "dog",
      "score": 0.7328268885612488
    }
  ],
  "image": "xxxxxx"
}
从源码看,上述接口契约与仓库实现一一对应:服务端点常量
INFER_ENDPOINT = "/open-vocabulary-detection"以及请求/响应模型(InferRequest、DetectedObject、InferResult)定义于 paddlex/inference/serving/schemas/open_vocabulary_detection.py,其中InferRequest的三个字段(image、prompt、thresholds)与上表完全一致。
多语言调用服务示例
Python
import base64
import requests

API_URL = "http://localhost:8080/open-vocabulary-detection"  # 服务URL
image_path = "./open_vocabulary_detection.jpg"
output_image_path = "./out.jpg"

# 对本地图像进行Base64编码
with open(image_path, "rb") as file:
    image_bytes = file.read()
    image_data = base64.b64encode(image_bytes).decode("ascii")

payload = {"image": image_data, "prompt": "walking man . bus ."}  # Base64编码的文件内容或者图像URL

# 调用API
response = requests.post(API_URL, json=payload)

# 处理接口返回数据
assert response.status_code == 200, f"{response.status_code}"
result = response.json()["result"]
with open(output_image_path, "wb") as file:
    file.write(base64.b64decode(result["image"]))
print(f"Output image saved at {output_image_path}")
print("\nDetected objects:")
print(result["detectedObjects"])
3.3 📱 端侧部署
端侧部署将计算和数据处理放在用户设备本身,设备直接处理数据而不依赖远程服务器。PaddleX 支持将模型部署在 Android 等端侧设备上,详细流程请参考 PaddleX 端侧部署指南。你可以根据需求选择合适的方式部署模型产线,进而进行后续的 AI 应用集成。
4. 二次开发
当前产线暂不支持微调训练,仅支持推理集成。关于该产线的微调训练,计划在未来版本支持。因此,若业务场景需要特定的开放词汇检测能力,当前最可行的做法是利用 GroundingDINO-T / YOLO-Worldv2-L 已有的零样本泛化能力,通过精心构造提示词(如将类别名按 . 分隔、描述性短语等)来覆盖目标场景。
5. 多硬件支持
当前产线暂时仅支持 GPU 和 CPU 推理。关于该产线对更多硬件(如 NPU、DCU 等)的适配,计划在未来版本支持。在多设备场景下,可通过 create_pipeline(device=...) 或 CLI 的 --device 参数指定推理设备;各硬件平台的详细安装与使用说明可参考 PaddleX 多设备使用指南。
6. 常见问题与调优建议
- 检测框过少或漏检:可适当降低
box_threshold(如从 0.3 降到 0.2),让更多低置信度候选框通过过滤;同时检查提示词是否覆盖了目标类别的常见表述。 - 误检框过多:提高
box_threshold过滤低置信度框,或提高text_threshold使标签判定更严格。 - 提示词写法:GroundingDINO 使用
"{类别1} . {类别2} . {类别3} ."的点分隔格式,且预处理会自动为未以.结尾的提示词补全句号(见GroundingDinoTextProcessor.pre_caption);若切换为 YOLO-World 模型,则提示词需改为逗号分隔的类别列表。 - 结果中标签为空:
text_threshold过高导致 logits 未能超过阈值从而无法解码出短语时,可适当降低该值。
以上调优均只需在 predict 调用或配置文件中调整阈值参数即可生效,无需重新训练模型。